U prvom delu ove objave bavili smo se pitanjem koji podaci imaju smisla u izbornoj prognozi. Sada dolazi manje glamurozan, ali često važniji problem: kada su ti podaci zaista bili poznati?
To pitanje na prvi pogled deluje administrativno. U praksi može odlučiti da li smo napravili stvarnu istorijsku prognozu ili sofisticirani trik u kojem modelu iz 2022. diskretno damo podatke objavljene 2023, zatim se zadivimo njegovoj preciznosti i proglasimo ga genijalnim. Glava 3 upravo zato upozorava da prognoziranje ne zahteva samo dobre podatke nego i rekonstrukciju informacionog skupa koji je tada stvarno postojao.
Najbolji prediktor izbora je rezultat koji još nije bio poznat
Zamislimo da pokušavamo da procenimo koliko bi naš model dobro prognozirao neke ranije izbore. Danas otvorimo bazu RZS-a, skinemo najnovije serije zaposlenosti, zarada i drugih pokazatelja, dodamo konačne izborne rezultate i savremenu klasifikaciju stranaka. Model radi fantastično.
Problem je što današnja baza nije ista baza koju je prognostičar mogao imati nekoliko nedelja pre tih izbora. Ekonomska statistika može biti naknadno revidirana. Demografske procene mogu sadržati kasnije informacije. Koalicije koje danas izgledaju logično možda tada još nisu postojale. Čak se i anketa objavljena pre izbora može odnositi na teren koji je završen posle našeg navodnog datuma prognoze.
Model tada nije „video obrazac“. Video je budućnost kroz zadnja vrata. To je pristrasnost usled gledanja unapred, a u izbornom prognoziranju može proizvesti upravo one istorijske grafikone od kojih analitičar počne da veruje da je otkrio političku fiziku.
Jedni podaci žive dnevno, drugi mesečno, a izbori jednom u nekoliko godina
Još jedan problem jeste što različiti podaci imaju različite satove. Ankete se pojavljuju nepravilno. Inflacija i zaposlenost uglavnom mesečno. BDP kvartalno. Popis povremeno. Medijski i digitalni podaci mogu biti dnevni ili čak gotovo trenutni. Izborni rezultat se, srećom po birače a pomalo nesrećom po statističare, pojavljuje samo jednom po izbornom ciklusu.
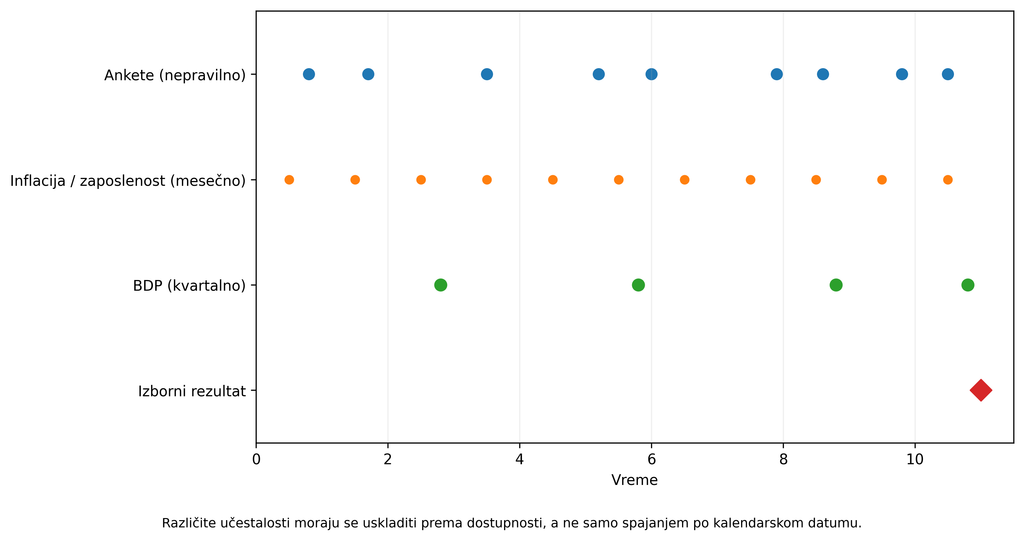
Slika 3.2. Podaci različitih vremenskih učestalosti. Ankete, mesečni indikatori, kvartalni BDP i izborni rezultat ne postaju istovremeno poznati samo zato što ih možemo staviti na istu vremensku osu.
Nije dovoljno spojiti sve redove prema kalendarskom datumu. Ako je BDP za prvi kvartal objavljen u maju, prognoza napravljena 15. aprila ne sme da ga koristi samo zato što se podatak odnosi na januar–mart. Referentni period odgovara na pitanje šta podatak opisuje. Datum objave odgovara na mnogo važnije prognostičko pitanje: kada je analitičar mogao da ga zna?
Podatak može opisivati prošlost i ipak pripadati budućnosti
Ovo je jedna od najvažnijih, a najmanje uzbudljivih ideja cele knjige. Svako opažanje ima najmanje dva sata: period na koji se odnosi i trenutak kada je postalo dostupno. Ako postoje revizije, dobija i treći. Prognostičar zatim ima sopstveni „presek“, tačan trenutak nakon kojeg nijedna nova informacija više ne sme ući u određenu verziju prognoze.
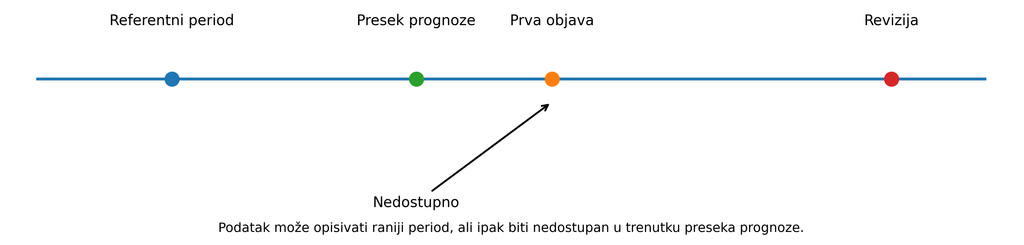
Slika 3.3. Problem datuma objavljivanja podataka. Statistika može opisivati raniji period, ali ako je prvi put objavljena posle preseka prognoze, tadašnjem prognostičaru nije bila dostupna.
Ovo je naročito važno kada retrospektivno ocenjujemo modele. Današnja istorijska ekonomska serija često je „lepša“ od one koju su ljudi zaista gledali u realnom vremenu. Ako modelu damo revidiranu prošlost, a zatim ga hvalimo zato što je bolje prognozirao, napravili smo takmičenje u kojem jedan učesnik dobija odgovore pre testa.
Ipsos pre zatvaranja biračkih mesta i Ipsos posle zatvaranja nisu ista vrsta informacije
Izbori od 25. oktobra pružili su gotovo savršen primer. Tri dana pre glasanja Ipsos je procenjivao Ujedinjenu Srbiju na 47,4%, Studentsku listu na 40% i izlaznost na 64,7%. Kao što smo videli u prvom delu, to istraživanje je imalo jasno opisan uzorak, metod prikupljanja i naručioca.
Nakon zatvaranja biračkih mesta, CeSID i Ipsos više nisu raspolagali samo odgovorima ljudi o tome šta nameravaju da urade. Koristili su stratifikovani uzorak od 750 biračkih mesta i prikupljali stvarne podatke o izlaznosti i rezultatima. Njihova završna projekcija na 100% uzorka dala je Studentskoj listi 53,0% i 141 mandat, a Ujedinjenoj Srbiji 38,8% i 103 mandata, veoma blizu preliminarnim zvaničnim rezultatima.
To nije kontradikcija tipa „Ipsos je u četvrtak zaboravio statistiku, a u nedelju je ponovo naučio“. To su dva potpuno različita informaciona problema. Pre izbora pokušavamo da izmerimo preference i predvidimo ponašanje koje se još nije dogodilo. Posle zatvaranja birališta uzorkujemo rezultat koji se već dogodio. Druga informacija je mnogo neposrednija.
CRTA je uradila nešto slično na svom slučajnom reprezentativnom uzorku od 500 biračkih mesta i procenila Studentsku listu na 52,45%, a Ujedinjenu Srbiju na 39,2%. To lepo pokazuje zašto u ozbiljnoj bazi moramo razlikovati anketu, predizbornu prognozu, izlazni ili izborno-noćni uzorak i zvanični rezultat. Svi su „podaci o izborima“, ali nisu ista vrsta podatka.
Hiljade biračkih mesta nisu hiljade izbora
Druga vrsta privida nastaje kada pređemo sa nacionalnog nivoa na opštine i biračka mesta. Srbija ima hiljade biračkih mesta, pa baza odjednom izgleda veoma velika. To je odlično za geografsku analizu, lokalne obrasce, modele izlaznosti i izbornu forenziku. Ali tih nekoliko hiljada redova ne znači da smo dobili nekoliko hiljada nezavisnih parlamentarnih izbora.
Sva biračka mesta dele isti izborni dan, isti izborni zakon, veliki deo nacionalne kampanje i mnoge zajedničke političke šokove. Zato je „imam 8.000 biračkih mesta“ statistički potpuno drugačija tvrdnja od „imam 8.000 nezavisnih izbora“. Glava 3 posebno upozorava na ovu zamenu količine redova količinom nezavisne informacije.
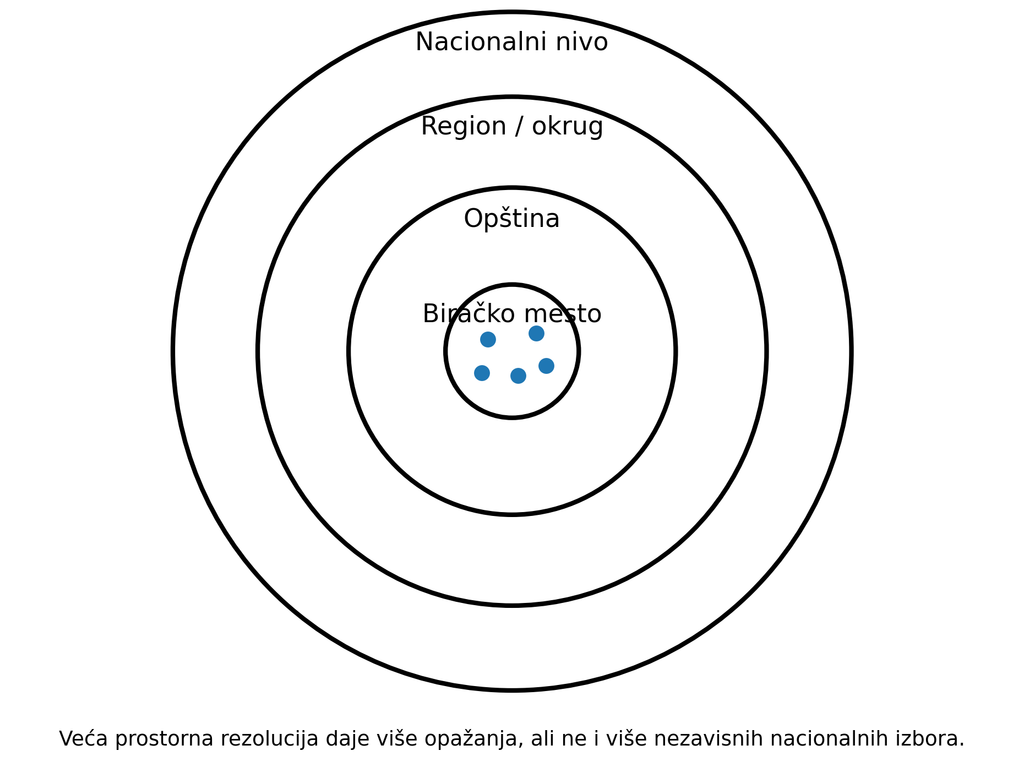
Slika 3.4. Geografska rezolucija baze za prognoziranje u Srbiji. Više prostornih jedinica daje detaljniju sliku, ali ne stvara nove nezavisne nacionalne izborne cikluse.
Tu se pojavljuje i ekološka greška. Ako opština sa velikim udelom zaposlenih u javnom sektoru ima visok rezultat vlasti, iz toga ne sledi da su upravo zaposleni u javnom sektoru proizveli taj rezultat. Možda su u pitanju starost, struktura naselja, obrazovanje, lokalna ekonomija ili nešto četvrto. Korelacija opština nije automatski ponašanje pojedinaca.
Stranke imaju nezgodnu naviku da menjaju ime, društvo i rodbinu
Političke liste dodatno komplikuju istorijsku bazu. Stranke se spajaju, dele, menjaju koalicije, nastaju nove liste, a stari brendovi ponekad nastavljaju život u sasvim drugačijoj konfiguraciji. Ako A i B zajedno nastupe na jednim izborima, a sledeći put A ide sa C dok B nastupa samostalno, koliko glasova iz prethodnog ciklusa „pripada“ A+C?
Ne postoji čisto tehnički odgovor. To je modelska odluka. Zato Glava 3 insistira da baza posebno beleži pravni identitet stranke, zvanični identitet liste i analitički kontinuitet koji istraživač koristi.
Ovo je posebno važno za Srbiju, gde izborna scena ume da menja koalicioni raspored brže nego što analitičar uspe da promeni nazive kolona. Ako se istorijski glasovi prenesu sa stare na novu listu, ta odluka treba da bude dokumentovana. Ne treba je sakriti pod naslovom „čišćenje podataka“, jer smo upravo doneli političko-modelsku pretpostavku.
Nedostaje nije uvek isto što i nedostaje
Još jedna mala stvar koja kasnije postaje velika: nisu sve prazne ćelije iste. Podatak možda nikada nije izmeren. Možda postoji, ali nije objavljen. Možda će biti objavljen, ali u trenutku prognoze još nije bio dostupan. Ili možda uopšte nije primenljiv, kao prethodni izborni rezultat za potpuno novu listu.
Ako sve to kodiramo kao isto „NA“, izgubili smo informaciju. U prvom slučaju imamo problem merenja, u drugom transparentnosti, u trećem vremenske dostupnosti, a u četvrtom samu strukturu političkog problema. Dobar prognostički sistem zato čuva ne samo broj nego i razlog zbog kojeg broja nema.
Reproduktivnost nije samo „evo GitHub“
Objaviti kôd je odlično, ali nije dovoljno. Ako isti kôd pokrenemo sledeće godine nad revidiranom verzijom ekonomske baze, možemo dobiti drugačiju „istorijsku prognozu“. Zato Glava 3 traži trag od objavljenog rezultata unazad: koja verzija modela, koja obrađena baza, koja verzija sirovih podataka i koji originalni izvor.
Za svaku prognozu trebalo bi sačuvati datum preseka, verziju kôda, verzije podataka, pravila povezivanja lista i relevantne postavke modela. Ako se koriste simulacije, korisno je sačuvati i sama simulaciona izvlačenja. To možda nije seksi deo predizborne televizije, ali je ono što kasnije omogućava da se ozbiljno odgovori na pitanje: „Šta ste tačno znali kada ste ovo objavili?“
Ko je onda bio „najprecizniji“?
Posle izbora već je počelo očekivano takmičenje. Vreme je pregledalo više predizbornih procena i zaključilo da je BIRODI-jev centralni scenario bio brojčano najbliži realizovanom rezultatu, dok su Ipsos i Faktor Plus pogrešno procenili čak i pobednika. NSPM je pogodio redosled vodećih lista, ali je procenio mnogo manju razliku nego što se pojavila u rezultatu.
To je korisna informacija, ali ako želimo profesionalno poređenje, moramo unapred definisati šta znači „najprecizniji“. Gledamo li prosečnu apsolutnu grešku svih lista? Samo dve najveće? Izlaznost? Prelazak cenzusa? Mandate? Da li poredimo ankete sprovedene četiri meseca pre izbora sa procenom urađenom tri dana pre izbora? Da li poređenje uključuje model koji se sam opisao kao scenario?
Ako metriku izaberemo tek nakon rezultata, možemo gotovo uvek pronaći kategoriju u kojoj je naš omiljeni model pobedio. I tu se vraćamo istoj ideji kao kod podataka: pravila treba definisati pre nego što vidimo odgovor.
BIRODI-jev relativno dobar rezultat zato jeste razlog da njegov model ozbiljno analiziramo. Nije razlog da ga posle jednog izbornog ciklusa kanonizujemo. Isto tako, veliki promašaj Ipsosa nije razlog da zaključimo da je sve što je ta agencija ikada izmerila bezvredno. Mnogo zanimljivije pitanje jeste koja je komponenta procesa zakazala, merenje preferencije, model izlaznosti, tretman neodlučnih, zajednička anketna greška ili nešto drugo.
Baza podataka je deo modela
Glava 3 na kraju predlaže da se srpski prognostički sistem ne pravi kao jedna gigantska tabela, već kao povezana istraživačka infrastruktura: izbori, liste, kontinuitet lista, ankete, rezultati po biračkim mestima, demografija, ekonomija, mediji, režimski indikatori, digitalni tragovi, forenzičke oznake, verzije podataka i svako pojedinačno pokretanje prognoze.
Možda zvuči manje uzbudljivo od pitanja „ko pobeđuje u nedelju?“, ali upravo od toga zavisi da li ćemo jednog dana moći da razlikujemo dobar model od modela koji je samo imao sreće.
Najvažnije pitanje za svaku novu promenljivu zato nije: „Možemo li je skinuti sa interneta?“
Bolje je pitati: šta ona meri, kada smo je mogli znati, gde pripada i da li zaista poboljšava prognozu?
Ako na ta pitanja nemamo odgovor, možda nam ne treba još podataka.
Možda nam treba bolja disciplina.

Director of Wellington based My Statistical Consultant Ltd company. Retired Associate Professor in Statistics.
Has a PhD in Statistics and over 45 years experience as a university professor, consultant, international researcher and government advisor.