Ovim tekstom nastavljam seriju objava o prognoziranju izbornih rezultata, zasnovanu na knjizi koju trenutno pripremam. Ideja serije ostaje ista: deo sadržaja knjige želim da izložim javnosti pre njenog završetka, dovoljno jednostavno da bude koristan i čitaocima koji nisu statističari, ali bez skrivanja problema koji prognoziranje izbora čine ozbiljnim metodološkim poslom. Ako komentari i kritike pokažu da je nešto nejasno, previše pojednostavljeno ili pogrešno naglašeno, utoliko bolje, još uvek postoji vreme da se to popravi u knjizi.
U prethodnim objavama bavili smo se pitanjem šta anketa zaista meri i zašto isti procenat ne mora imati isto značenje u različitim političkim okolnostima. Sada je vreme za korak unazad: od jedne ankete ka celom skladištu podataka koje savremeni prognostičar može da prikupi. A tog materijala danas ima toliko da najveći problem više nije „nemamo podatke“, nego „imamo skoro sve što postoji na internetu, pa šta sad?“. Glava 3 polazi upravo od upozorenja da više podataka može proizvesti i lošiju, a ne bolju prognozu.
Kada Excel sa 200 kolona počne da izgleda kao nauka
Ankete, prethodni izborni rezultati, inflacija, zarade, zaposlenost, starost, obrazovanje, lokalna demografija, popularnost predsednika ili vlade, vreme provedeno na televiziji, ton medijskog izveštavanja, protesti, Google pretrage, Facebook, X, TikTok, broj lajkova i verovatno još nešto što će biti izmišljeno pre nego što završim ovu knjigu, sve se danas može pretvoriti u kolonu.
Tu nastaje opasna intuicija: ako jedan model koristi deset promenljivih, a drugi sto, drugi mora biti pametniji. Ne mora. Ako dovoljno dugo tražimo kroz stotine promenljivih, gotovo sigurno ćemo pronaći nekoliko koje su se u prošlosti fantastično slagale sa izbornim rezultatom. Problem počinje kada zaboravimo da smo ih pronašli nakon što smo već videli rezultat. Tada više ne prognoziramo budućnost, nego vrlo inventivno objašnjavamo prošlost. Upravo zato Glava 3 insistira da svaka promenljiva dobije analitičku ulogu pre nego što dobije počasno mesto u modelu.
Anketa nije inflacija, a Google nije birač
Podaci za prognoziranje izbora mogu se, pojednostavljeno, rasporediti u četiri široke porodice. Prvu čine neposredna izborna merenja: ankete, prethodni rezultati, izlaznost, glasovi i podaci sa biračkih mesta. Drugu čine strukturni podaci i sastav biračkog tela: demografija, zaposlenost, prihodi, obrazovanje, region i drugi pokazatelji koji mogu pomoći modeliranju izlaznosti ili formiranju šireg strukturnog očekivanja.
Treća porodica opisuje politički kontekst: medijsku izloženost, protestnu aktivnost, zavisnost od javnog sektora, indikatore političkog pritiska, administrativnu mobilizaciju ili unapred definisane pokazatelje izbornog integriteta. Četvrtu čine eksperimentalni i digitalni signali, Google Trends, društvene mreže, sentiment i druge veoma brze, vrlo moderne i povremeno vrlo zavodljive brojke. Problem nastaje kada se sve četiri porodice tretiraju kao da su samo različiti termometri iste političke temperature. Nisu.
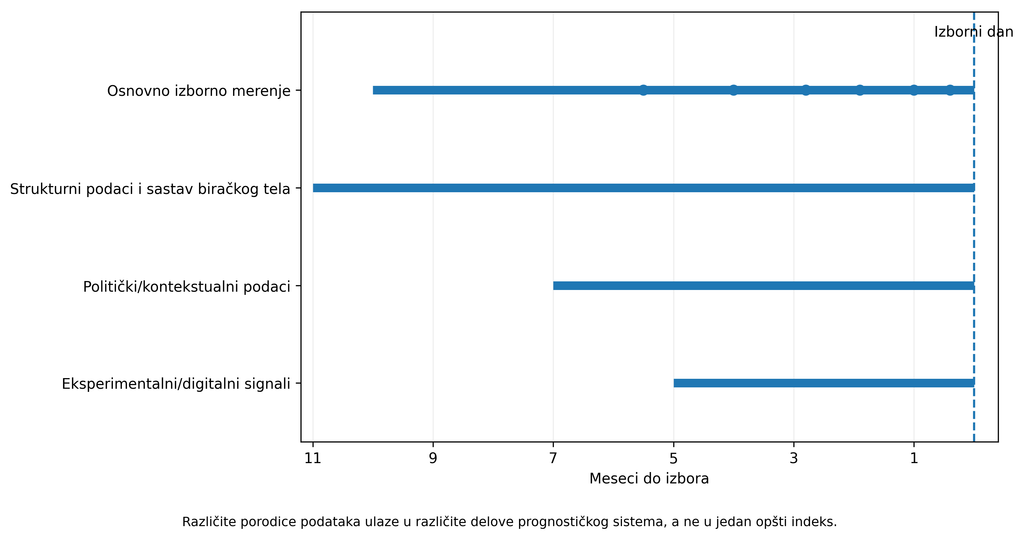
Slika 3.1. Jedna izborna prognoza, četiri sloja podataka. Različite porodice podataka mogu doprineti istom prognostičkom sistemu, ali ne mere istu pojavu i ne treba ih mehanički sabirati u jedan „izborni indeks“.
Dobar model zato ne pita samo „da li je promenljiva povezana sa izborima?“. Pita šta ona meri. Anketa pokušava da meri iskazanu političku preferenciju. Demografija opisuje populaciju na koju želimo da generalizujemo rezultate. Inflacija može doprineti strukturnom očekivanju o stanju vlasti, ali inflacija nije skrivena anketa. Medijska zastupljenost meri informaciono okruženje, ali petnaest minuta televizijskog programa nije petnaest dodatnih glasova. Google pretraga imena političara pokazuje interesovanje, ali interesovanje može značiti podršku, bes, skandal ili činjenicu da je neko upravo napravio spektakularnu glupost pred kamerama.
Ipsos tri dana pred izbore: odličan primer zašto su metapodaci važni
Pred izbore 25. oktobra dobili smo gotovo školski primer za ovu raspravu. Ipsos je 22. oktobra objavio procenu zasnovanu na istraživanju sprovedenom od 20. do 22. oktobra na 3.624 ispitanika. Procena je davala listi „Aleksandar Vučić – Ujedinjena Srbija“ 47,4%, Studentskoj listi 40%, a listi Ivice Dačića 3,2%. Očekivana izlaznost bila je 64,7%. Naručilac istraživanja bila je upravo lista „Aleksandar Vučić – Ujedinjena Srbija“. Ipsos je pritom objavio niz važnih metodoloških informacija: ciljnu populaciju, način prikupljanja podataka, kombinaciju telefonskog i onlajn uzorka, tretman opredeljenih birača i pretpostavku o 2,5% nevažećih listića.
To što je istraživanje naručila politička lista ne čini istraživanje automatski nevalidnim. Ali upravo zato metapodaci moraju biti vidljivi, a profesionalna granica između interesa naručioca i analitičkog postupka naročito čvrsta. Agencija ne bi trebalo da prilagođava metod, interpretaciju ili način predstavljanja onome ko plaća istraživanje. Ako rezultat treba da bude javni profesionalni proizvod, javnost mora moći da vidi kako je nastao, koje pretpostavke sadrži i koja vrsta neizvesnosti nije obuhvaćena običnom uzoračkom greškom.
Preliminarni rezultati koje je RIK utvrdio 26. oktobra u 20 časova, na osnovu 97,56% obrađenih biračkih mesta, pokazivali su 52,71% za Studentsku listu, 39,17% za Ujedinjenu Srbiju i 2,17% za Dačićevu listu. To je vrlo velika razlika u odnosu na Ipsosovu predizbornu procenu i, što je posebno edukativno, oba vodeća rezultata našla su se daleko van intervala koje je Ipsos objavio uz svoje procene.
To ne znači da je svaki statistički interval „pogrešan“. Znači da interval zasnovan prvenstveno na uzoračkoj grešci ne obuhvata automatski sve izvore prognostičke greške: neodaziv, pogrešno modeliranu izlaznost, kasnu mobilizaciju, sistematsku anketnu grešku, probleme obuhvata ili promene u poslednjim danima. Kada se anketna procena predstavi kao procena konačnog izbornog rezultata, odgovornost postaje veća, a ne manja.
Isti podaci, različit naslov
Zanimljivo je i kako su isti Ipsosovi podaci predstavljeni. Alo je vest naslovio tvrdnjom da je Vučićeva lista „ubedljivo na prvom mestu sa 47,4 odsto“. Tekst je, doduše, preneo dosta metodoloških detalja, uključujući naručioca, ali naslov je već napravio politički okvir u kojem čitalac ulazi u priču.
Politika je koristila neutralniji naslov „Vučićeva lista na 47,4 odsto, Studentska na 40 odsto“ i takođe prenela metodološke podatke i intervale. Danas je posebno jasno naveo da je istraživanje naručila Ujedinjena Srbija, da su procenti lista računati među opredeljenima i da je procena nevažećih glasova bila dodatna pretpostavka Ipsosa.
To je korisna lekcija: čak i kada se osnovni podaci korektno prenesu, naslov je takođe deo interpretacije. Agencija ne kontroliše svaki medijski naslov, ali može otežati političko prepakivanje svog rada tako što će jasno odvojiti: „ovo je opažanje“, „ovo je pretpostavka“, „ovo je modelirana procena“ i „ovo je ograničenje“.
CRTA, NSPM i Faktor Plus nisu tri reda iste Excel tabele
U prethodnom tekstu već smo videli koliko su se poslednja istraživanja razlikovala. CRTA je u junskom istraživanju licem u lice na 2.324 ispitanika među opredeljenima davala Studentskoj listi 44,9%, a SNS-u 35,7%. NSPM je u telefonskom istraživanju sprovedenom od 25. septembra do 5. oktobra na 1.050 ispitanika među opredeljenima davao Studentskoj listi 44,5%, a Ujedinjenoj Srbiji 42,7%. Faktor Plus je u istraživanju od 16. do 20. septembra na 986 ispitanika davao Ujedinjenoj Srbiji 48,6%, a Studentskoj listi 37,1%.
Najgora stvar koju možemo uraditi jeste samo poređati te procente u kolone i ponašati se kao da se razlikuju jedino zato što je neko „bolji“ ili „gori“. Istraživanja su sprovedena u različito vreme, različitim metodama, sa različitim tretmanom opredeljenih i neizjašnjenih. Upravo je zato baza anketa iz Glave 3 zamišljena tako da uz procenat čuva i anketnu kuću, naručioca, početak i kraj terena, datum objave, uzorak, ciljnu populaciju, način anketiranja, tretman neopredeljenih, izvor i eventualne kasnije ispravke.
Drugim rečima, 44,5 nije potpuna informacija. Bez metapodataka, to je samo broj koji čeka da ga neko politički usvoji.
Demografija nije ukras, ali nije ni anketa
Demografski podaci imaju potpuno drugačiju funkciju. Starost, obrazovanje, region, urbanizacija i zaposlenost pomažu nam da razumemo ko čini biračko telo i da li uzorak ankete liči na populaciju na koju želimo da zaključujemo. U kasnijim delovima knjige ti podaci postaju važni za modeliranje izlaznosti i MRP, ali već ovde je važno razumeti da demografija nije još jedan „rejting“.
Slična zabuna postoji sa ekonomskim podacima. Inflacija, realne zarade, nezaposlenost ili popularnost vlade mogu imati prognostičku vrednost, ali ne treba ih ubacivati u prosek anketa kao da predstavljaju dodatne ispitanike. Srbija ovde ima i poseban problem: broj nacionalnih parlamentarnih izbora dovoljno relevantnih za moderan model je mali. Možemo imati stotine mesečnih ekonomskih opažanja, ali nemamo stotine nezavisnih nacionalnih izbora. Više redova u Excelu ne proizvodi automatski više istorije.
„Klijentelistička opština“ nije promenljiva
Politički kontekst je još osetljiviji. Ako smatramo da zavisnost od javnog sektora može uticati na mobilizaciju, mnogo je bolje meriti udeo zaposlenih u javnom sektoru nego opštinama lepiti etiketu „klijentelističke“. Ako nas zanima medijska neravnopravnost, treba meriti vreme, ton, vidljivost, doseg publike i izloženost, a ne jednostavno uneti ocenu „mediji nisu fer“. Glava 3 upravo to traži: politički sugestivnu etiketu pretvoriti u merljivu hipotezu.
BIRODI je, na primer, pred izbore objavio monitoring televizije Informer prema kojem je Ujedinjena Srbija bila gotovo isključivo predstavljena pozitivno, dok je Studentska lista bila gotovo isključivo predstavljena negativno. Takav monitoring može biti važan dokaz medijske neravnopravnosti i veoma relevantan politički podatak. Ali čak ni precizno izmeren broj minuta ne govori automatski koliko je procenata glasova proizveo. To su dva različita pitanja i upravo ih dobra arhitektura podataka ne sme pomešati.
Google zna šta tražimo, ne zna za koga ćemo glasati
Digitalni podaci su naročito zavodljivi jer ih ima mnogo i stižu brzo. Ako Google pretrage za nekog političara naglo eksplodiraju, analitičar može lako pomisliti da je otkrio budući izborni talas. Problem je što Google ne zna da li smo ime ukucali zato što političara podržavamo ili zato što pokušavamo da saznamo šta je upravo izjavio i zašto je internet ponovo u plamenu.
Isto važi za društvene mreže. Hiljadu objava ne znači hiljadu birača, a deset hiljada interakcija ne znači deset hiljada glasova. Nekoliko veoma aktivnih naloga, aktivisti, botovi, novinari i algoritam platforme mogu napraviti mnogo buke bez reprezentativnosti. Zato Glava 3 digitalne tragove namerno ostavlja u eksperimentalnom sloju sve dok ne pokažu dodatnu prognostičku vrednost na izborima koji nisu korišćeni da bi signal bio pronađen.
A gde se u ovoj priči nalazi BIRODI?
BIRODI je krajem avgusta objavio model koji je kombinovao zvanične izborne rezultate, više istraživanja, uključujući CRTA-u, NSPM, Faktor Plus, Nacija TV i Ipsos, kao i demografske promene, modeliranje izlaznosti i Monte Karlo simulacije. Centralni scenario davao je Studentskoj listi 48,5%, a listi SNS/Vučića 38,6%. BIRODI je pritom naglašavao da to nije klasična anketa i da rezultat treba čitati kao analitički model/scenario mogućeg ishoda.
Posle izbora, Vreme je u poređenju više javno dostupnih predizbornih procena ocenilo da je BIRODI-jev model brojčano bio najbliži rezultatu, dok su Ipsos i Faktor Plus pogrešno predvideli pobednika. To jeste zanimljivo i zaslužuje analizu, ali jedna dobra procena još nije dokaz da je svaki element modela ispravan. Jedan izbor može pokazati da je model bio dobar ovog puta; ozbiljna procena zahteva više izbora, unapred definisanu metriku greške i testiranje u kojem ne menjamo pravila nakon što vidimo rezultat.
Drugim rečima, ni kada smo najbliži rezultatu ne dobijamo pravo da preskočimo metodologiju.
Podaci prvo moraju dobiti posao
Glavna poruka prvog dela Glave 3 zato nije „skupljajte što više“. Naprotiv. Za svaku novu promenljivu prvo treba pitati koji posao treba da obavlja. Da li meri podršku? Opisuje populaciju? Informiše izlaznost? Daje strukturni prior? Predstavlja politički kontekst? Ili je tek eksperimentalni signal koji zaslužuje testiranje?
Tek posle toga dolazi pitanje da li zaista poboljšava prognozu.
Možda je najbolja zaštita od „big data“ romantike vrlo jednostavna: pre nego što novu kolonu unesemo u model, treba da znamo zašto je tamo. Ako ne znamo, onda ona nije novi dokaz.
Ona je samo još jedna kolona.

Director of Wellington based My Statistical Consultant Ltd company. Retired Associate Professor in Statistics.
Has a PhD in Statistics and over 45 years experience as a university professor, consultant, international researcher and government advisor.