Serija „Prognoziranje izbornih rezultata: između statistike, politike i neizvesnosti” — Forenzika Izbora
Kada procenat izgleda preciznije nego što zaista jeste
Zamislimo da na jednoj televiziji analitičar saopšti kako će Lista A na predstojećim parlamentarnim izborima osvojiti 41% glasova. Na drugoj televiziji pojavljuje se njegov kolega, takođe sa prognozom od 41%. Publika bi razumno mogla da zaključi da su se stručnjaci konačno oko nečega složili. U Srbiji bi to već samo po sebi bila vest.
Međutim, prvi analitičar procenjuje da će se rezultat gotovo sigurno nalaziti između 40% i 42%, dok drugi smatra da je realan raspon od 35% do 47%. Obojica daju istu centralnu procenu, ali ne i istu prognozu. Prvi izražava mnogo veću sigurnost, dok drugi priznaje znatno širi prostor za različite izborne ishode.
U prethodnoj objavi videli smo zašto anketa, procena sadašnjeg stanja, scenario i izborna prognoza nisu sinonimi. Sada prelazimo na drugo fundamentalno pitanje: čak i kada znamo šta prognoziramo, koliko zapravo možemo biti sigurni u rezultat?
Ovo pitanje posebno je važno za Srbiju, gde se javna rasprava o istraživanjima javnog mnjenja često svodi na poređenje nekoliko procenata. U politički polarizovanom okruženju ti brojevi lako postaju argumenti za neizbežnu pobedu, siguran poraz ili potpuno izvesnu parlamentarnu većinu. Statistička neizvesnost tada nestaje, kao da je neprijatan gost kojeg je trebalo izostaviti sa konferencije za medije.
Isti procenat ne znači i istu prognozu
Svaka ozbiljna izborna prognoza trebalo bi da sadrži više od jednog broja. Centralna procena pokazuje gde model smešta tipičan ili najverovatniji deo očekivanih ishoda, zavisno od načina njenog definisanja. Međutim, ona ne govori koliko se drugi mogući ishodi udaljavaju od te vrednosti.
Zato se koriste prediktivni intervali (engl. predictive intervals). Ako model za Listu A daje centralnu procenu od 41% i 80-procentni prediktivni interval od 35% do 47%, on poručuje da, prema njegovim podacima i pretpostavkama, tom intervalu pripada približno 80% njegove prognozne raspodele. Preostalih 20% nalazi se izvan njega, ispod donje ili iznad gornje granice.
Važno je razumeti šta takav interval ne znači. On nije garancija da će rezultat sigurno biti unutar navedenih granica. Nije ni automatski dokaz da je model pouzdan, jer interval ima smisla samo u okviru pretpostavki na kojima je model izgrađen. Model koji zanemaruje važan politički mehanizam može proizvoditi veoma uverljive, ali pogrešno kalibrisane intervale.
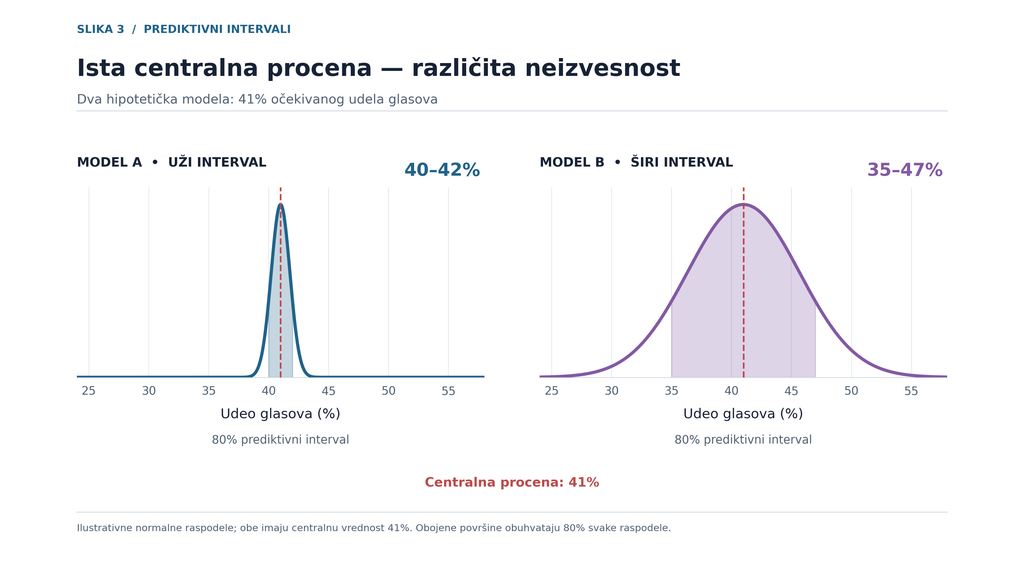
[SLIKA 3 — Dve prognozne raspodele sa istom centralnom procenom od 41%, ali različitim 80-procentnim prediktivnim intervalima: 40–42% i 35–47%.]
Zamislimo da konačni rezultat bude 45%. Za drugi model takav ishod nije naročito iznenađujući, jer se nalazi unutar njegovog prediktivnog intervala. Za prvi je znatno problematičniji, jer je model predvideo veoma uzak raspon mogućih rezultata.
Ako bismo ocenjivali samo centralne procene, oba modela imala bi istu apsolutnu grešku od četiri procentna poena. Međutim, takvo ocenjivanje zanemarilo bi važnu razliku između njihovih tvrdnji o neizvesnosti.
Šta znači kada neko ima 68% šanse da pobedi?
Pretpostavimo sada da model procenjuje kako Lista A ima 68% verovatnoće da završi na prvom mestu. U medijima se to ponekad prevodi kao „Lista A je siguran pobednik”. Takav naslov možda dobro funkcioniše u političkoj kampanji, ali ne predstavlja korektno tumačenje verovatnoće.
Verovatnoća od 68% znači da model, uz svoje podatke i pretpostavke, pobedi Liste A dodeljuje veću verovatnoću nego njenom porazu. Istovremeno, postoji preostalih 32% verovatnoće da se očekivana pobeda ne ostvari.
Ako Lista A na kraju izgubi, to ne znači automatski da je prognoza bila pogrešna. Dogodio se ishod kojem je model unapred dodelio značajnu, mada manju verovatnoću. Sasvim drugačije trebalo bi oceniti model koji je istoj listi pripisao 99% šanse za pobedu.
To ne znači da probabilističke prognoze ne mogu pogrešiti. Mogu, ali njihovu pouzdanost treba ocenjivati kroz veći broj uporedivih prognoza i odgovarajuće statističke kriterijume, a ne samo na osnovu toga da li je jedna pojedinačna prognoza pogodila pobednika.
Srbija: zašto 3,1% može biti važnije od 40%
U Srbiji je pitanje neizvesnosti posebno zanimljivo zbog izbornog sistema. Na parlamentarnim izborima 250 poslaničkih mandata raspodeljuje se prema D'Ontovom sistemu, a redovne izborne liste moraju da osvoje najmanje 3% glasova od ukupnog broja birača koji su glasali da bi učestvovale u raspodeli mandata. Za manjinske liste postoje posebna pravila, koja ćemo detaljnije razmotriti u kasnijim objavama.
Zamislimo fiktivne parlamentarne izbore na kojima modeli daju sledeće centralne procene: Lista A — 39%, Lista B — 34%, Lista C — 3,1% i Lista D — 2,8%. Preostale glasove dobijaju druge i manjinske liste. Pretpostavimo da su svi procenti izraženi na istoj osnovi, odgovarajućoj zakonskoj definiciji izbornog praga.
Na prvi pogled najveću pažnju privlače Liste A i B. Međutim, sa stanovišta sastava budućeg parlamenta, značajan izvor neizvesnosti mogu predstavljati upravo Liste C i D, koje se nalaze neposredno oko redovnog izbornog cenzusa.
Pretpostavimo da Lista C ima centralnu prognozu od 3,1%, ali da samo u 54% simuliranih izbornih ishoda prelazi cenzus. Tvrdnja „Lista C dobija 3,1%” tada može stvoriti pogrešan utisak da je njen ulazak u parlament gotovo izvestan. Ispravnije bi bilo saopštiti da je centralna procena 3,1%, ali da prema modelu postoji približno 54% verovatnoće prelaska izbornog praga.
Drugim rečima, prelazak cenzusa je gotovo otvoreno pitanje.
Lista A, sa druge strane, može imati centralnu prognozu od 39% i prediktivni interval od 36% do 42%. Njena apsolutna neizvesnost mnogo je veća, ali njeno učešće u raspodeli mandata praktično nije pod znakom pitanja. Kod Liste C i pomeranje od nekoliko desetina procentnog poena može promeniti odgovor na pitanje da li će uopšte imati poslaničke mandate.
To je primer nelinearnosti: mala promena glasova blizu institucionalnog praga može izazvati veliku promenu parlamentarne zastupljenosti.
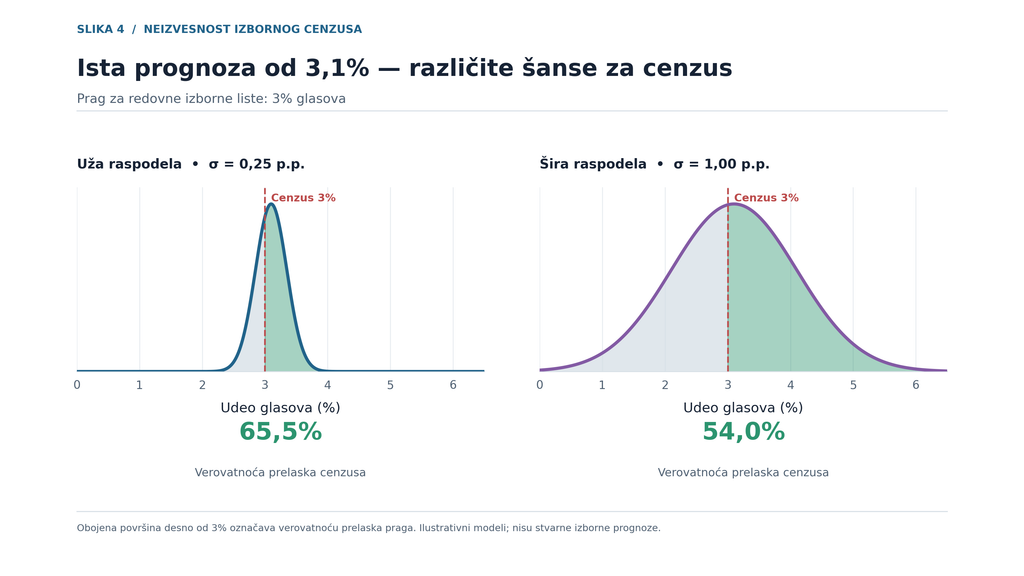
[SLIKA 4 — Dve prognozne raspodele oko centralne vrednosti 3,1%, sa vertikalnom linijom na 3%.]
Monte Karlo: deset hiljada izbora koje niko nije održao
Kako možemo proceniti verovatnoću da neka lista pređe cenzus, osvoji najviše glasova ili doprinese formiranju parlamentarne većine? Jedan od korisnih računarskih postupaka jeste Monte Karlo simulacija (engl. Monte Carlo simulation).
Pretpostavimo da statistički model, umesto jednog rezultata, daje raspodelu mogućih izbornih ishoda. Iz te raspodele možemo generisati, recimo, 10.000 simuliranih izbora i izbrojati u koliko njih određena lista prelazi cenzus. Ako se to dogodi u približno 5.400 simulacija, modelom procenjena verovatnoća prelaska praga iznosi oko 54%.
Nije reč o deset hiljada stvarnih izbora, već o računarski generisanim ishodima koji odražavaju neizvesnost ugrađenu u model. Simulacija je način obrade te neizvesnosti; ona nije nezavisna teorija izbornog ponašanja.
U knjizi koristim jednostavnu R demonstraciju sa dva hipotetička modela. Oba daju centralnu procenu od 3,1%, ali jedan pretpostavlja mnogo manju raspršenost rezultata od drugog. Čitalac može promeniti stepen neizvesnosti i neposredno posmatrati kako se menja verovatnoća prelaska cenzusa, iako centralna procena ostaje ista.
Ta početna vežba namerno je pojednostavljena. Realističan model mora dodatno voditi računa da su udeli svih lista međusobno povezani, da zbir glasova ima određena ograničenja i da se izborna pravila primenjuju na odgovarajuće definisane glasove. Nije dovoljno za svaku listu nezavisno generisati proizvoljnu normalnu raspodelu i očekivati da dobijemo verodostojan izborni sistem.
Postoji još jedna važna pouka. Model koji koristi 100.000 simulacija nije nužno bolji od onog koji koristi 10.000. Povećanje broja simulacija smanjuje računarsku aproksimacionu grešku, ali ne uklanja pristrasnost zbog loših podataka ili pogrešnih pretpostavki.
Čak i milion simulacija pogrešno postavljenog modela može dati veoma precizan odgovor na pogrešno pitanje. Statistička sofisticiranost tada ne rešava problem, već ga samo predstavlja sa impresivnim brojem decimala.
Glasovi nisu mandati, a simulacija nije istraživanje javnog mnjenja
Posle procene glasova sledi pitanje koje naročito interesuje političke aktere: kako će izgledati parlament? U Srbiji se glasovi pretvaraju u mandate primenom izbornog cenzusa, posebnih pravila za manjinske liste i D'Ontovog sistema raspodele.
Međutim, projekcija mandata i prognoza glasova nisu isto. Ako neko unese proizvoljno odabrane procente u kalkulator mandata, dobiće matematički određenu raspodelu poslaničkih mesta, pod navedenim pravilima. Takav rezultat ne postaje istraživanje javnog mnjenja samo zato što je prikazan u tabeli koja izgleda kao izborna prognoza.
Zanimljiv stvarni primer zabeležio je Istinomer početkom oktobra 2026. godine. Na društvenim mrežama pojavila se tabela predstavljena kao rezultat istraživanja CRTA-e, sa procentima glasova i tačnim brojevima mandata. Istinomer je utvrdio da navedeni procenti ne odgovaraju objavljenim rezultatima CRTA-inih istraživanja. Format je podsećao na rezultat korišćenja alata Mandator, namenjenog računanju raspodele mandata na osnovu unetih procenata.
Ovaj slučaj pokazuje zašto treba proveriti poreklo brojeva, čak i kada je tabela vizuelno uverljiva. Analitički alat, korisnički scenario, istraživanje javnog mnjenja i prognoza izbora predstavljaju različite proizvode. Pripisivanje rezultata simulatora istraživačkoj organizaciji, bez dokaza da je upravo ona procenila ulazne procente, može dovesti javnost u zabludu.
Dobar model raspodele mandata mora sačuvati neizvesnost glasova. Umesto da samo jedan prosečan izborni rezultat pretvorimo u mandate, svaki simulirani ishod treba posebno provesti kroz izborna pravila. Tek tako možemo procenjivati verovatnoće prelaska cenzusa, osvajanja određenog broja mandata ili formiranja većine od najmanje 126 poslanika.
Kako znati da li je prognoza dobra?
Kvalitet prognoze ne može se oceniti samo pitanjem da li je pogodila pobednika. Treba proceniti i tačnost njenih centralnih vrednosti, širinu prediktivnih intervala i realističnost prognoziranih verovatnoća.
U literaturi se koriste dva važna pojma: kalibracija (engl. calibration) i oštrina prognoze (engl. sharpness). Kalibracija se odnosi na slaganje prognoziranih verovatnoća sa učestalošću stvarnih ishoda. Ako model velikom broju uporedivih događaja pripisuje verovatnoću od 80%, približno četiri od pet takvih događaja trebalo bi zaista da se dogode.
Oštrina se odnosi na koncentrisanost prognozne raspodele. Prognoza koja dopušta skoro svaki mogući rezultat neće često biti očigledno iznenađena, ali neće biti naročito korisna. Cilj je proizvesti što informativnije intervale, a da se pritom ne žrtvuje odgovarajuća kalibracija.
Dobar model zato mora pokazati da je precizan tamo gde dokazi to opravdavaju, a oprezan tamo gde informacije nisu dovoljne. Ne postoji nagrada za statističku hrabrost koja se sastoji od samouverenog objavljivanja neutemeljeno uskih intervala.
Prognoze takođe treba proveravati na ranijim izborima, koristeći samo informacije koje su tada zaista bile dostupne. Nije pošteno rekonstruisati prognozu izbora iz 2022. koristeći ankete ili podatke objavljene 2024. godine. To se naziva pristrasnost usled gledanja unapred (engl. look-ahead bias).
Modelu ne treba dozvoliti da poznaje budućnost dok tvrdi da je prognozira.
Neizvesnost nije isto što i neznanje
Postoji još jedno ograničenje koje se lako zaboravlja. Verovatnoće koje model proizvodi odnose se na neizvesnost predstavljenu njegovim podacima i pretpostavkama. One ne moraju obuhvatiti događaje ili mehanizme koje model nije razmatrao.
Na primer, u snažno polarizovanom društvu neki ispitanici mogu izbegavati otkrivanje političkih preferencija. Mobilizacija određenih grupa može zavisiti od institucionalnih pritisaka, dostupnosti medija ili organizacionih resursa. Tok kampanje može biti promenjen događajima koje nije moguće pouzdano predvideti.
Takve probleme ne treba rešavati proizvoljnim političkim „korektivnim koeficijentima”. Ono što možemo empirijski proceniti treba proceniti, ono što ne možemo dovoljno pouzdano izmeriti treba uključiti u analizu osetljivosti ili eksplicitne scenarije, a preostala ograničenja jasno saopštiti javnosti.
Ako model tvrdi da neka lista ima 70% šanse za pobedu, to znači 70% prema tom modelu, a ne apsolutnu verovatnoću koja postoji nezavisno od kvaliteta podataka i pretpostavki.
Odgovornost istraživača i pravo javnosti da razume
Koje informacije bi, dakle, trebalo da prati javno objavljivanje izborne prognoze? Čitaocu moraju biti dostupni datum prognoze, ciljni datum izbora, korišćeni podaci i izvori, metodološki pristup, najvažnije pretpostavke i jasno navedena neizvesnost.
Ako je reč o istraživanju javnog mnjenja, potrebno je dokumentovati ciljnu populaciju, uzorak, način anketiranja, tretman neopredeljenih i ograničenja merenja. Ako je reč o scenariju, uslovi od kojih zavisi rezultat moraju biti vidljivi. Kod simulacije i projekcije mandata treba navesti odakle potiču ulazni procenti, kako je generisana neizvesnost i koja izborna pravila su primenjena.
Ova pravila moraju važiti jednako za komercijalne agencije, organizacije civilnog društva, univerzitetske istraživače i nezavisne analitičare. To nije zahtev da svi objavljuju identične modele ili kompletnu sirovu bazu podataka bez zaštite ispitanika, već zahtev da javnost dobije dovoljno informacija za odgovorno tumačenje rezultata.
Istraživačke organizacije pritom imaju i obrazovnu odgovornost. Nije dovoljno predstaviti broj i očekivati da građani sami znaju razliku između uzoračke greške, prediktivnog intervala, uslovnog scenarija i izborne prognoze. U polarizovanom društvu nepotpune informacije mogu dodatno zaoštriti političke sukobe, bez obzira na to ko ih objavljuje.
Zaključak: 3,1% nije obećana poslanička klupa
Kada istraživanje ili prognoza kaže da neka redovna izborna lista ima 3,1% podrške, ne znamo automatski da li će preći cenzus. Kada model prognozira pobedu sa verovatnoćom od 68%, to ne znači da je pobeda zagarantovana. Kada simulator proizvede 250 poslaničkih mandata, to ne dokazuje da su ulazni procenti dobijeni reprezentativnim istraživanjem.
Ovi primeri ilustruju osnovni princip cele serije: odgovorno prognoziranje ne podrazumeva uklanjanje neizvesnosti, već njeno merenje, testiranje i razumljivo saopštavanje.
U narednim objavama razmatraćemo zašto političko okruženje, dostupnost medija, pritisci na birače i nejednake mogućnosti mobilizacije mogu dodatno komplikovati merenje podrške u Srbiji. Zatim ćemo preći na izvore podataka, metodologiju anketa i statističke modele koji mogu povezati sadašnje informacije sa budućim izbornim ishodima.
Do tada, kada sledeći put pročitate da je neka lista „sigurno iznad cenzusa” sa procenjenih 3,1%, slobodno postavite sasvim jednostavno pitanje: kolika je verovatnoća?
Jer izborni cenzus nije zaštićen ni od statističke neizvesnosti ni od političke samouverenosti.
Izvori i dalje čitanje
- Republička izborna komisija — O izborima za narodne poslanike, pravila o izbornom pragu, manjinskim listama i raspodeli mandata.
- Istinomer — Ne, objava sa Fejsbuka ne prikazuje podatke Crtinog istraživanja, 1. oktobar 2026.
- Gneiting, Balabdaoui i Raftery (2007), Probabilistic Forecasts, Calibration and Sharpness.
- Bunn i Salo (1993), Forecasting with Scenarios.
- Stoetzer i sar. (2019), Forecasting Elections in Multiparty Systems: A Bayesian Approach Combining Polls and Fundamentals.

Director of Wellington based My Statistical Consultant Ltd company. Retired Associate Professor in Statistics.
Has a PhD in Statistics and over 45 years experience as a university professor, consultant, international researcher and government advisor.